Olá pessoal!
Eu vou dar um curso de Jev em algumas semanas e achei que seria legal a gente ter um material base para começar. Eu decidi escrever esse artigo como parte conceitual do curso. A gente vai começar por ela, e como eu sempre digo nos meus treinamentos: a base de todo o aprendizado é a documentação oficial do sistema.
Hoje, com inteligência artificial, a gente consegue utilizá-la a nosso favor e criar formatos de aprendizado que são mais eficientes para o nosso estilo de aprendizado. Ou seja, se eu tenho mais facilidade com áudio, eu vou eventualmente ouvir um livro ao invés de ler um livro. Se eu tenho mais facilidade com imagens, eu vou eventualmente gerar um mind map de um livro, que vai ser mais fácil de eu ter um entendimento do que se eu ouvir o livro.
Então, usem todos esses artefatos de IA, mas tenham certeza de que vocês estão utilizando a documentação oficial.
Para a gente começar esse artigo e também a aula, a gente vai abrir o site da TypeSafe, que é a empresa que desenvolveu o primeiro System One, que é um modelo chamado Jev.
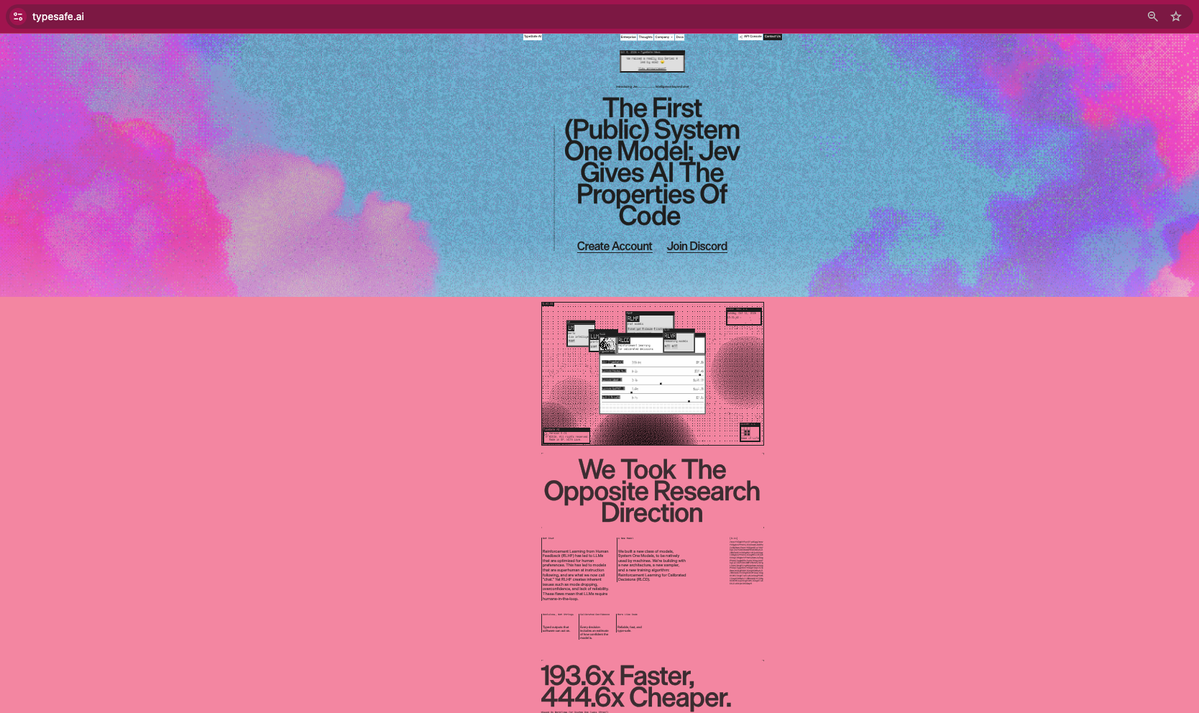
Na página principal da empresa, a gente vê algumas informações bem interessantes, alguns comparativos de performance e custo.
A gente segue, então, para a página da informação do lançamento do Jev, com alguns detalhes a mais do que é o modelo.
https://typesafe.ai/blog/introducing-system-one-models-and-jev
Como a gente pode ver nessa página, a gente tem mais informações sobre o Jev, inclusive um link para a documentação oficial – importante: estamos utilizando a versão 1.13.0 neste artigo.
https://docs.typesafe.ai/introduction (v1.13.0)
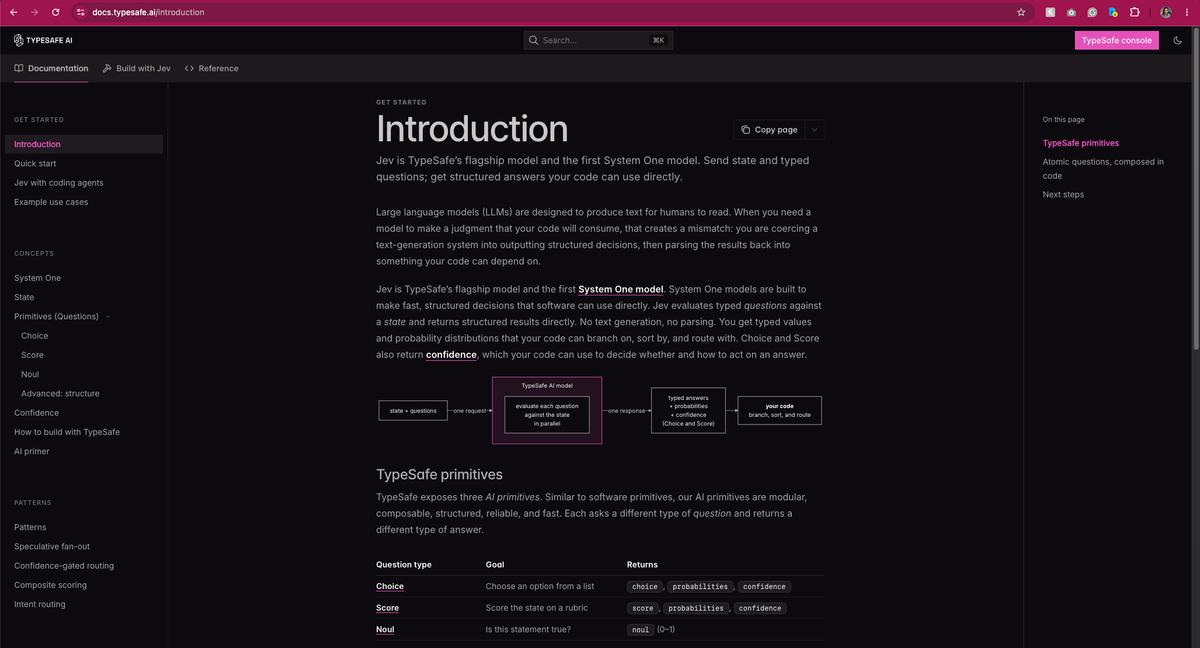
Joia! baseado nesses sites, então temos o seguinte:
O modelo mental: os dois sistemas de Kahneman
TypeSafe chamou Jev de modelo “System One” por um motivo. Opus e Astra são ambos System Two.
O livro Thinking, Fast and Slow de Daniel Kahneman descreve dois sistemas cognitivos:
System One Rápido, automático, intuitivo. Reconhece um rosto, seleciona uma bola, classifica uma forma. Sem deliberação – apenas reconhecimento de padrões em alta velocidade. Este é o Jev.
System Two Lento, deliberado, analítico. Resolve uma prova matemática, escreve uma redação, raciocina sobre um cenário complexo. Poderoso, mas custoso. Estes são Opus & Astra.
Arquitetura em resumo v1.13.0
Treinamento diferente, amostragem diferente, contratos de saída diferentes.
Jev System One
Claude Opus 5.5 LLM
GPT-6 Astra LLM
RLCD vs RLHF: como cada um aprende
A forma como o modelo é treinado define como ele se comporta. Jev e os LLMs aprendem de formas completamente diferentes.
RLCD
Treinado para acertar decisões e saber quando não tem certeza. Em muitas previsões, resultados com probabilidade 0,8 devem acontecer cerca de 80% das vezes. Isso descreve o grupo, não uma resposta. confidence é um score de dispersão, não essa probabilidade.
A recompensa no treinamento vem de fazer a decisão certa, não de “soar bem” para um humano.
Seu código usa essas probabilidades para decidir quando confiar na resposta e quando escalar para um humano.
RLHF Opus 5.5 & Astra
Treinado para dar respostas que humanos consideram boas. Durante o treinamento, humanos avaliam várias respostas e escolhem a melhor. O modelo aprende a gerar texto que “soa” útil, correto e seguro.
Exemplo: se você pede “classifique esse ticket”, o LLM pode responder “Com base na análise do conteúdo, eu classificaria como alta prioridade porque…” – ótimo para humanos lerem, mas seu código precisa fazer parsing dessa string para extrair o valor “high”.
Resultado: raciocínio incrível, escrita fluente, conversa natural – mas a saída é sempre texto que precisa ser interpretado.
Os três primitivos de Jev (v1.13.0)
Em vez de uma API prompt→texto, Jev expõe operações atômicas e componíveis. Todas executam em paralelo. Importante: tem mais um tipo mas não vamos considerá-lo neste artigo pois ele é um modelo avançado.
- Classificar um bug: crítico / alto / médio / baixo
- Rotear um PR para o time certo: frontend / backend / infra / docs
- Categorizar um teste que falhou: flaky / bug real / ambiente
- Detectar tipo de erro em log: timeout / auth / validação / rede
score é o valor esperado, não o índice do nível.- Pontuar a qualidade de uma descrição de PR (0-4)
- Avaliar a severidade de um alerta de segurança
- Medir a cobertura semântica de um caso de teste
- Ranquear a relevância de resultados de busca de logs
- Esse commit introduz uma breaking change?
- Essa mensagem de erro é amigável para o usuário?
- Esse teste cobre o cenário descrito no ticket?
- Esse log contém dados sensíveis (PII)?
Mesma tarefa, três paradigmas
Três tarefas comuns usando os três primitivos de Jev. Veja como cada modelo resolve.
Inglês é o idioma principal de treino do Jev, e onde a precisão é melhor. Outros idiomas funcionam, mas não igualmente bem. Teste no seu conteúdo antes de depender deles. As instructions dos exemplos ficam em inglês.
Choice: classificar falha de teste
import { TypeSafeClient } from '@typesafe-ai/sdk';

const client = new TypeSafeClient();
const result = await client.systemOne({
  model: 'jev-latest',
  state: {
    test: failure.test,
    error: failure.error,
    history: failure.history
  },
  questions: {
    category: {
      type: 'choice',
      instructions: 'Root cause?',
      criteria: {
        product_bug: 'A real bug in product code',
        test_bug: 'Bug in the test itself',
        environment: 'Infra or env issue',
        flaky: 'Non-deterministic pass/fail'
      }
    }
  }
});
// result.answers.category.choice → "flaky"
// result.answers.category.confidence → 0.65
// result.answers.category.probabilities
//   → { flaky: 0.74, test_bug: 0.12,
//        environment: 0.11,
//        product_bug: 0.03 }
// ~150ms
const res = await anthropic
  .messages.create({
  model: "claude-opus-5-5",
  max_tokens: 256,
  messages: [{
    role: "user",
    content: `Classify this test failure.
      Test: ${failure.test}
      Error: ${failure.error}
      History: ${failure.history}
      Reply: product_bug, test_bug,
      environment, or flaky`
  }]
});
// res.content[0].text:
// "Based on the intermittent pass/
//  fail pattern (PFPPFP), this is
//  likely **flaky**. The timeout in
//  the error suggests a race
//  condition in the async setup."
// Sem probabilidades. Precisa de parsing.
// ~4s
const res = await openai
  .chat.completions.create({
  model: "gpt-6-astra",
  max_completion_tokens: 256,
  response_format: {
    type: "json_object"
  },
  messages: [{
    role: "user",
    content: `Classify this test failure.
      Test: ${failure.test}
      Error: ${failure.error}
      History: ${failure.history}
      Options: product_bug, test_bug,
      environment, or flaky
      JSON: { "category": "..." }`
  }]
});
// res.choices[0].message.content:
// '{ "category": "flaky",
//    "reasoning": "The PFPPFP
//    pattern indicates..." }'
// Estruturado, mas sem
// probabilidades calibradas.
// ~3s
Score: impacto no release
import { TypeSafeClient } from '@typesafe-ai/sdk';

const client = new TypeSafeClient();
const result = await client.systemOne({
  model: 'jev-latest',
  state: {
    test: failure.test,
    error: failure.error,
    history: failure.history
  },
  questions: {
    releaseImpact: {
      type: 'score',
      instructions: 'Release impact?',
      criteria: [
        'No user impact',
        'Minor, easy workaround',
        'Feature degraded',
        'Critical journey broken'
      ]
    }
  }
});
// result.answers.releaseImpact.score
//   → 2.86 (valor esperado, 0-3)
// result.answers.releaseImpact.confidence
//   → 0.84
// ~120ms
const res = await anthropic
  .messages.create({
  model: "claude-opus-5-5",
  max_tokens: 256,
  messages: [{
    role: "user",
    content: `Rate the release impact of
      this failure 0-3.
      0=No user impact
      1=Minor, easy workaround
      2=Feature degraded
      3=Critical journey broken
      Test: ${failure.test}
      Error: ${failure.error}
      Reply with just the number.`
  }]
});
// res.content[0].text:
// "I'd rate this a 3 - the checkout
//  flow is a critical user journey
//  and the failure blocks payment
//  processing entirely."
// Sem confidence. Precisa de parsing.
// ~5s
const res = await openai
  .chat.completions.create({
  model: "gpt-6-astra",
  max_completion_tokens: 256,
  response_format: {
    type: "json_object"
  },
  messages: [{
    role: "user",
    content: `Rate the release impact of
      this failure 0-3.
      0=No user impact
      1=Minor, easy workaround
      2=Feature degraded
      3=Critical journey broken
      Test: ${failure.test}
      Error: ${failure.error}
      JSON: { "score": N }`
  }]
});
// res.choices[0].message.content:
// '{ "score": 3, "rationale":
//    "Blocks checkout flow" }'
// Estruturado, mas sem
// confidence calibrado.
// ~4s
Noul: retry vai passar?
import { TypeSafeClient } from '@typesafe-ai/sdk';

const client = new TypeSafeClient();
const result = await client.systemOne({
  model: 'jev-latest',
  state: {
    test: failure.test,
    error: failure.error,
    history: failure.history
  },
  questions: {
    retryWillPass: {
      type: 'noul',
      instructions: 'Would re-running this test, with no code changes, most likely make it pass?'
    }
  }
});
// result.answers.retryWillPass.noul → 0.91
// sem campo confidence separado
// ~100ms
const { noul } = result.answers.retryWillPass;
if (noul > 0.7) autoRetry();
const res = await anthropic
  .messages.create({
  model: "claude-opus-5-5",
  max_tokens: 256,
  messages: [{
    role: "user",
    content: `Would re-running this test,
      with no code changes, most
      likely make it pass? YES or NO.
      Test: ${failure.test}
      Error: ${failure.error}
      History: ${failure.history}`
  }]
});
// res.content[0].text:
// "YES - Based on the intermittent
//  pass/fail pattern (PFPPFP), this
//  appears to be a flaky test. A
//  retry would very likely pass."
// Sem probabilidade. Precisa de parsing.
// ~4s
const res = await openai
  .chat.completions.create({
  model: "gpt-6-astra",
  max_completion_tokens: 256,
  response_format: {
    type: "json_object"
  },
  messages: [{
    role: "user",
    content: `Would re-running this test,
      with no code changes, most
      likely make it pass?
      Test: ${failure.test}
      Error: ${failure.error}
      History: ${failure.history}
      JSON: { "retry": true/false }`
  }]
});
// res.choices[0].message.content:
// '{ "retry": true, "reasoning":
//    "Intermittent pattern suggests
//    flaky test" }'
// Estruturado, mas sem
// probabilidade calibrada.
// ~3s
Perfil de performance (v1.13.0)
A TypeSafe informa que Jev é 193.6x mais rápido e 444.6x mais barato que LLMs em workflows de System One. Uma comparação separada coloca o preço de entrada 238x abaixo do Claude Fable 5.1.
Os preços podem variar de uma data para outra. Confira a página de preços de cada fornecedor para os valores atuais. As barras são ilustrativas, fora de escala.
Comparação de características (v.1.13.0)
| Capacidade | Jev | Opus 5.5 | Astra |
|---|---|---|---|
| Previsibilidade da saída | Schema garantido | Schema com structured outputs | Schema com structured outputs |
| Pontuações de confiança | Choice e Score | – | – |
| Geração de texto | – | Fronteira | Fronteira |
| Profundidade de raciocínio | – | Pensamento estendido | 5 níveis de raciocínio |
| Uso de ferramentas / agentes | – | MCP, uso de computador | Funções, uso de computador |
| Classificação / roteamento | Feito para isso (255) | Via prompting | Via prompting |
| Risco de alucinação | Sem rótulo novo | Mitigado | Mitigado |
| Saída máxima | Choice / score / noul | 128K tokens | 128K tokens |
Exemplos de resposta do Jev
Cada primitivo retorna um JSON estruturado. Choice e Score trazem confidence na própria resposta. Noul devolve só a probabilidade de sim. Jev não inventa rótulos fora do criteria.
Nota: output_tokens nestes exemplos é uma contagem de uso, não uma cobrança. A saída é grátis. Você paga só pelos input_tokens.
Nota: estes JSONs seguem o formato da API e as fórmulas de confidence publicadas. São ilustrações, não uma resposta capturada ao vivo.
{
  "model": "jev-1.13.0",
  "answers": {
    "category": {
      "type": "choice",
      "choice": "flaky",
      "confidence": 0.65,
      "probabilities": {
        "flaky":       0.74,
        "test_bug":    0.12,
        "environment": 0.11,
        "product_bug": 0.03
      }
    }
  },
  "usage": {
    "input_tokens": 342,
    "output_tokens": 34
  }
}
{
  "model": "jev-1.13.0",
  "answers": {
    "releaseImpact": {
      "type": "score",
      "score": 2.86,
      "confidence": 0.84,
      "legend": {
        "0": "No user impact",
        "1": "Minor, easy workaround",
        "2": "Feature degraded",
        "3": "Critical journey broken"
      },
      "probabilities": {
        "0": 0.00,
        "1": 0.02,
        "2": 0.10,
        "3": 0.88
      }
    }
  },
  "usage": {
    "input_tokens": 289,
    "output_tokens": 18
  }
}
{
  "model": "jev-1.13.0",
  "answers": {
    "retryWillPass": {
      "type": "noul",
      "noul": 0.91
    }
  },
  "usage": {
    "input_tokens": 356,
    "output_tokens": 20
  }
}
// Jev ainda devolve a opção mais provável.
// Não inventa um rótulo fora do criteria.
// confidence 0.04 = quase um empate:
{
  "model": "jev-1.13.0",
  "answers": {
    "category": {
      "type": "choice",
      "choice": "environment",
      "confidence": 0.04,
      "probabilities": {
        "environment": 0.28,
        "product_bug": 0.26,
        "test_bug":    0.24,
        "flaky":       0.22
      }
    }
  },
  "usage": {
    "input_tokens": 342,
    "output_tokens": 34
  }
}
// confidence 0.04 = não aja com base na escolha
// Seu código:
// if (confidence < 0.6)
//   escalateToHuman()
Quando usar cada um
Eles não são concorrentes. São ferramentas diferentes para trabalhos diferentes.
Jev se destaca em
- Classificação estruturada & roteamento
- Decisões em tempo real (sub-500ms)
- Pontuação e portas de verificação
- Guardrails sobre probabilidades
- Automação de alto volume e baixo custo
- Substituir árvores frágeis de if/else
Opus 5.5 se destaca em
- Raciocínio estendido & análise
- Geração de código & workflows agênticos
- Compreensão de documentos com contexto longo
- Orquestração de ferramentas via MCP
- Geração nuanceada e alinhada com segurança
- Sumarização & escrita criativa
Astra se destaca em
- Raciocínio em múltiplas etapas (5 níveis)
- Programação complexa & uso de ferramentas
- Tarefas multimodais (texto + visão)
- Integração com busca na web & arquivos
- Geração de grandes saídas (128K)
- Uso de computador & automação
A arquitetura real: componha os três
Os sistemas mais fortes usam cada um onde ele brilha. Jev como a camada rápida de triagem – classificar, pontuar, filtrar – decidindo o que precisa de um LLM de fato. Opus 5.5 ou Astra para o raciocínio pesado, geração e tarefas agênticas que exigem pensamento profundo. Depois Jev novamente para validar, pontuar e rotear a saída do LLM. System One lida com os 90% que são rotina em 200ms e custo quase zero. System Two fica com os 10% que precisam de pensamento profundo. O melhor equilíbrio entre custo e qualidade vem do pipeline, não de um único modelo.
Versão 1.14.0
No dia 14 de Outubro de 2026, a TypeSafe fez a release da versão1.14.0 – ela não está sendo considerada neste artigo. Para mais informações acesse a doc oficial: https://typesafe.ai/blog/jev-1-14
